OPTIMIZE TABLE
OPTIMIZE TABLE 通过合并较小的 Segment 和 Block 提升查询性能。合并后,如需回收符合清理条件的历史数据占用的存储空间,请使用 VACUUM TABLE。
为何需要优化?
Databend 数据存储:快照、段与块
快照(Snapshot)、段(Segment)和块(Block)是 Databend 用于数据存储的核心概念,Databend 利用它们构建表数据的分层存储结构。
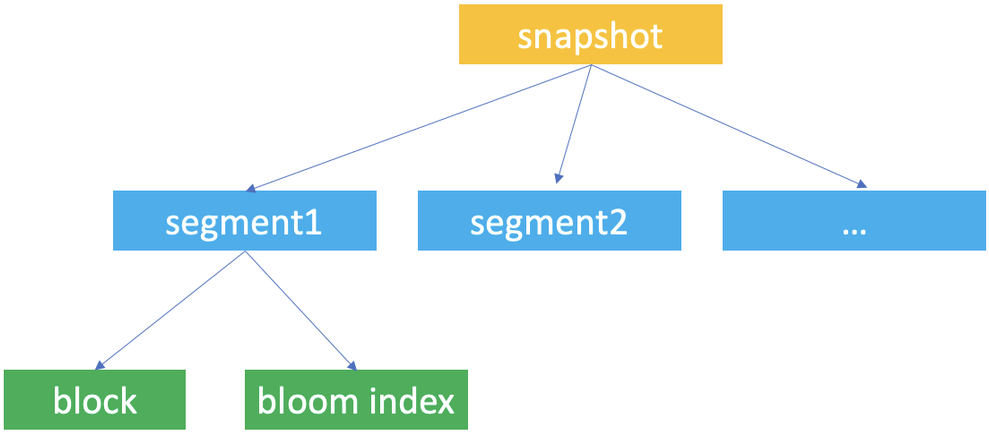
Databend 在数据更新时会自动创建表快照。快照代表表某一版本的段元数据。
使用 Databend 时,若通过 AT 子句检索并查询表的历史版本数据,通常需借助快照 ID 访问快照。
快照是一个 JSON 文件,不存储表数据,但记录了快照关联的段。对表执行 FUSE_SNAPSHOT 可查看保存的快照。
段是一个 JSON 文件,用于组织存储数据的块(至少 1 个,最多 1,000 个)。使用快照 ID 对快照执行 FUSE_SEGMENT 可查看该快照引用的段。
Databend 将实际表数据存储在 Parquet 文件中,并将每个 Parquet 文件视为一个块。使用快照 ID 对快照执行 FUSE_BLOCK 可查看该快照引用的块。
Databend 为每个数据库和表创建唯一 ID,用于存储快照、段和块文件,并将其保存至对象存储路径 <bucket_name>/<tenant_id>/<db_id>/<table_id>/。每个快照、段和块文件均以 UUID(32 位小写十六进制字符串)命名。
| 文件 | 格式 | 文件名 | 存储文件夹 |
|---|---|---|---|
| 快照 | JSON | <32bitUUID>_<version>.json | <bucket_name>/<tenant_id>/<db_id>/<table_id>/_ss/ |
| 段 | JSON | <32bitUUID>_<version>.json | <bucket_name>/<tenant_id>/<db_id>/<table_id>/_sg/ |
| 块 | parquet | <32bitUUID>_<version>.parquet | <bucket_name>/<tenant_id>/<db_id>/<table_id>/_b/ |
表优化
在 Databend 中,建议的理想块大小为 100 MB(未压缩)或 1,000,000 行,每个段包含 1,000 个块。为最大化表优化效果,需明确何时以及如何应用各种优化技术,如段合并和块合并。
- 使用 COPY INTO 或 REPLACE INTO 命令向包含聚簇键(Cluster Key)的表写入数据时,Databend 会自动触发重聚簇以及段和块合并流程。
分布式执行与升级兼容性
在集群中,Databend 会自动分布式执行块合并。enable_distributed_compact 已弃用且不再生效。将其设为 0 不会强制本地执行。
旧版本使用以下设置启用分布式合并。现有脚本可以保留此语句,但新脚本不再需要它:
SET enable_distributed_compact = 1;
auto_compaction_segments_limit 接受 2 到 128 之间的值,包含两个边界。此设置限制写入后自动重聚簇所考虑的 Segment 数量。升级前,请检查设置了更大值的脚本。请将这些值调整到支持的范围。此设置不替代手动 OPTIMIZE TABLE 或 ALTER TABLE ... RECLUSTER 命令的 LIMIT 子句。
段合并(Segment Compaction)
当表存在过多小段(每段少于 100 个块)时,需进行段合并。
SELECT
  block_count,
  segment_count,
  IF(
              block_count / segment_count < 100,
              '该表当前需进行段合并',
              '该表当前无需段合并'
    ) AS advice
FROM
  fuse_snapshot('your-database', 'your-table')
    LIMIT 1;
语法
OPTIMIZE TABLE [database.]table_name COMPACT SEGMENT [LIMIT <segment_count>]
将小段合并为较大段,不重写数据 Block。
COMPACT SEGMENT LIMIT n 考虑最新的输入段。此限制不指定合并段数或输出段数。不需要合并的段可以保持不变。
不指定 LIMIT 时,Databend 会考虑当前快照中的所有段。
反复执行有限制的合并可能会一直保留较旧的碎片。当旧段也需要合并时,请定期执行不带 LIMIT 的 COMPACT SEGMENT。这些规则适用于 COMPACT SEGMENT,不适用于块合并。
示例
-- 检查是否需段合并
SELECT
  block_count,
  segment_count,
  IF(
              block_count / segment_count < 100,
              '该表当前需进行段合并',
              '该表当前无需段合并'
    ) AS advice
FROM
  fuse_snapshot('hits', 'hits');

+-------------+---------------+-------------------------------------+
| block_count | segment_count | advice                              |
+-------------+---------------+-------------------------------------+
|         751 |            32 | The table needs segment compact now |
+-------------+---------------+-------------------------------------+

-- 执行段合并
OPTIMIZE TABLE hits COMPACT SEGMENT;

-- 再次检查
SELECT
  block_count,
  segment_count,
  IF(
              block_count / segment_count < 100,
              '该表当前需进行段合并',
              '该表当前无需段合并'
    ) AS advice
FROM
  fuse_snapshot('hits', 'hits')
    LIMIT 1;

+-------------+---------------+---------------------------------------------+
| block_count | segment_count | advice                                      |
+-------------+---------------+---------------------------------------------+
|         751 |             1 | The table does not need segment compact now |
+-------------+---------------+---------------------------------------------+
有限制的合并示例
下面每条独立的插入语句都会创建一个段。第一次合并只考虑最新的两个段。后续不带限制的合并可以继续合并较旧的碎片。
CREATE TABLE compact_segment_latest_limit(a INT) BLOCK_PER_SEGMENT = 4;
INSERT INTO compact_segment_latest_limit VALUES (1);
INSERT INTO compact_segment_latest_limit VALUES (2);
INSERT INTO compact_segment_latest_limit VALUES (3);
INSERT INTO compact_segment_latest_limit VALUES (4);

OPTIMIZE TABLE compact_segment_latest_limit COMPACT SEGMENT LIMIT 2;

-- Expected counts: 3 segments, 4 blocks, 4 rows.
SELECT segment_count, block_count, row_count
FROM fuse_snapshot('default', 'compact_segment_latest_limit') LIMIT 1;

OPTIMIZE TABLE compact_segment_latest_limit COMPACT SEGMENT;

-- Expected counts: 1 segment, 4 blocks, 4 rows.
SELECT segment_count, block_count, row_count
FROM fuse_snapshot('default', 'compact_segment_latest_limit') LIMIT 1;

DROP TABLE compact_segment_latest_limit;
块合并(Block Compaction)
当表存在大量小块,或插入、删除、更新行比例较高时,需进行块合并。
可通过检查每个块的未压缩大小是否接近理想值 100 MB 来判断。
若大小小于 50 MB,建议执行块合并,表明存在过多小块:
SELECT
  block_count,
  humanize_size(bytes_uncompressed / block_count) AS per_block_uncompressed_size,
  IF(
              bytes_uncompressed / block_count / 1024 / 1024 < 50,
              '该表当前需进行块合并',
              '该表当前无需块合并'
    ) AS advice
FROM
  fuse_snapshot('your-database', 'your-table')
    LIMIT 1;
建议先执行段合并,再执行块合并。
语法
OPTIMIZE TABLE [database.]table_name COMPACT [LIMIT <segment_count>]
通过合并小块和段为较大块和段来优化表数据。
-
该命令会为最新表数据创建新快照(含合并后的段和块),不影响现有存储文件,因此需在合并后使用 VACUUM TABLE 回收符合条件的历史数据占用的存储空间。
-
根据表大小,执行可能耗时较长。
-
LIMIT 选项设置最大合并段数,Databend 将选择并合并最新段。
-
合并完成后,Databend 会自动对聚簇表执行重聚簇。
示例
OPTIMIZE TABLE my_database.my_table COMPACT LIMIT 50;
先合并数据,再清理符合条件的历史文件:
OPTIMIZE TABLE my_database.my_table COMPACT;
VACUUM TABLE my_database.my_table;